AIXX 백과사전 › 모델 항목 › GB300 NVL72
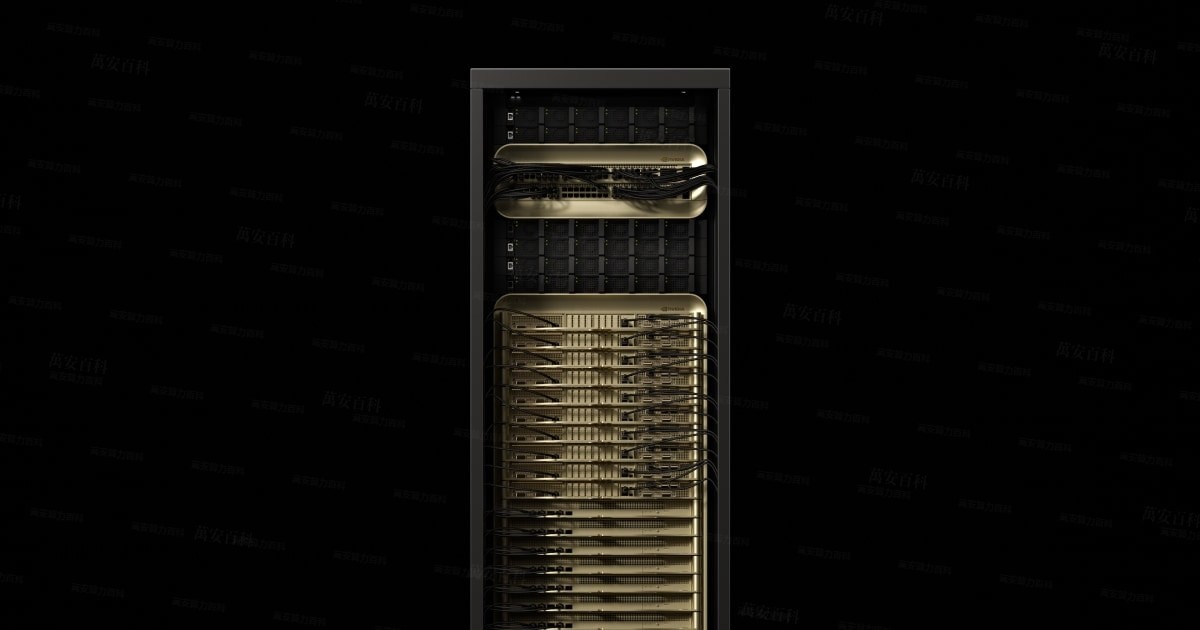
GB300 NVL72
개요OVERVIEW
GB300 NVL72(정식 명칭 NVIDIA GB300 NVL72, Blackwell Ultra 플랫폼의 플래그십 형태)는 NVIDIA가 2025년 3월 18일GTC에서 발표한랙 레벨 슈퍼노드로, 72개의 Blackwell Ultra GPU 와 36개의 Grace CPU 를 완전 수랭 랙 하나에 담고, 5세대 NVLink 풀 인터커넥트로 합계 130TB/s를 제공합니다——소프트웨어 관점에서 랙 전체는 하나의 가속기[1][3]。
입니다. 대화 속 'NVL72'라는 세 글자의 실체이기도 합니다: N은 NVLink 도메인, 72는 한 도메인 내 GPU 수를 의미합니다. 공식 발표 기준 전 세대 GB200 NVL72 대비 1.5배FP4 Tensor Core 공식 페이지 2열 표기 1,440 | 10,802 PFLOPS(2026-10 공식 페이지 검증, 두 열의 수치는 공식 각주 기준), GPU 메모리 합산 20TB HBM3e, 전력 132kW급 — 랙 단위 납품이란 것은, 구매 전에 그것을 수용할 수 있는 서버실이 먼저 있어야 한다는 뜻이다[1][2][3].
2026년 현물 시장에서 GB300 NVL72는 대규모 학습 및 추론 팩토리의 함대 기함: 2025년 8월 CoreWeave가 최초로 퍼블릭 클라우드에 올렸고, 2026년 9월 MLPerf Inference v6.1 데뷔에서 공개 벤치마크를 제시했으며, 같은 라운드에서 차세대 Vera Rubin NVL72도 공개되었다(GB300 대비 최대 3.7배, 공개 발표 기준[6]) — 플래그십의 자리는 기다려주지 않지만, 도입 장벽과 시스템 가격 역시 같은 스케일의 존재다(「냉각 및 배치」와「시세 밴드」 참조).
적용 시나리오FIT
AIXX Index(0–100): 본 데이터베이스는 공개 스펙 기반 가중 추정——랙 메모리 규모 40% + 인터커넥트 30% + 생태계 30%, 시나리오별 가중치 조정, 랙 레벨 추정 기준(싱글 카드 항목 기준과 상호 비교 불가). 90+ 플래그십급 · 75+ 우수 · 60+ 사용 가능 · 60 미만 부적합. 방법론은 투명하고 검증 가능하며, 성능 보장을 구성하지 않습니다.
연혁HISTORY
2025년 3월 18일, GTC 키노트에서 Blackwell Ultra 플랫폼 발표: 공식 발표 기준 GB300 NVL72는 GB200 NVL72 대비 1.5배 속도 향상, Cisco / Dell / HPE / Lenovo / Supermicro 등 16개 파트너가 같은 해 하반기부터 랙 단위 납품, GPU당 ConnectX-8 SuperNIC 800Gb/s 탑재[3].
2025년 7-9월, 첫 시스템 상륙: CoreWeave가 7월 첫 GB300 NVL72 도입을 발표하고, 8월 19일 세계 최초 GB300 NVL72 클라우드 인스턴스 정식 상용화(Dell 납품), 3분기 실적 보고서에 「First to deploy NVIDIA GB300 NVL72 systems」로 기재; Quanta는 9월부터 출하[8].
2026년 9월, MLPerf Inference v6.1: GB300 NVL72가 MLPerf 데뷔, MoE 벤치마크에서 전 세대 대비 최대 2.5배 향상; 같은 라운드에서 차세대 Vera Rubin NVL72도 데뷔, Qwen3-VL 인터랙션 시나리오에서 GB300 대비 최대 3.7배GB300 대비(NVIDIA 공식 블로그 기준) — 공개 벤치마크에서 「현역 플래그십 vs 후속 모델」이 처음으로 같은 무대에 올랐다[6][7].
대중국 방침 (중립): GB300은 미국 수출 통제 대상이며, 대중국 승인 목록에 포함되지 않았다(2026-10 공개 기준; 미국은 첨단 칩의 대중 허가에 「추정 거부」 정책을 유지, 2026년 1월 BIS 신규 규정 프레임워크 지속); 2026년 7월 대중국 수입이 승인·확대된 것은 H200이며, GB300급은 승인되지 않았다 — 현물 유통은 해외 및 자유무역지대 채널이 중심이다. 본 라이브러리는 공개 보도 기준만을 기록하며, 법적 의견을 구성하지 않는다[10].
기술 사양SPECIFICATIONS
| 항목 | 스펙 (GB300 NVL72 랙 레벨 · 공식 기준) |
|---|---|
| 구성 | 72× Blackwell Ultra GPU + 36× Grace CPU (2,592× Arm Neoverse V2 코어) |
| FP4 Tensor Core | 1,440 PFLOPS(dense) / 10,802 PFLOPS(스파스)——발표 보도 및 파트너 카탈로그에는 '1.1 EFLOPS급 FP4 추론' 기준도 병기 |
| FP8 / FP6 Tensor Core | 720 PFLOPS |
| FP16 / BF16 · TF32 | 360 / 180 PFLOPS |
| FP64 | 100 TFLOPS |
| GPU 메모리 합계 | 20TB HBM3e(288GB/카드 × 72 = 20.7TB, 추정 기준), 대역폭 최대 576TB/s |
| CPU 메모리 합계 | 17TB LPDDR5X(대역폭 14TB/s); 패스트 메모리 합계 37TB |
| GPU 간 인터커넥트 | NVLink 5세대 · 합계 130TB/s(GPU당 1.8TB/s) + 9× NVSwitch 트레이 풀 인터커넥트 |
| 랙 구조 | 18× 컴퓨트 트레이(트레이당 4 GPU + 2 Grace) + 9× NVSwitch 트레이 + 8× 33kW 파워 셸프 |
| 냉각 | 완전 수랭(fully liquid-cooled); 랙 내 CDU 250kW급; 트레이 레벨 + 랙 레벨 누액 감지 |
| 전원 | 132kW 구성 레벨(8× 33kW 파워 셸프); NVIDIA 참조 아키텍처 풀 로드 최대 142kW |
| 외부 네트워크 | GPU당 800Gb/s(ConnectX-8 SuperNIC ×4/트레이) + BlueField-3 DPU; Quantum-X800 InfiniBand / Spectrum-X Ethernet 확장 |
| 전 세대 / 차세대 | GB200 NVL72(1.5배 성능 차) / Vera Rubin NVL72(2026-09 데뷔) |
스펙은 NVIDIA 공식 공개 자료 기준[1][2]; FP4 dense는 공식 스펙 페이지의 희소성 미포함 기준, 1.1 EFLOPS는 발표/파트너 카탈로그 기준, 두 기준이 병존하며 각각 출처 표기; Tensor 연산력은 별도 표기가 없는 한 희소성 포함 기준; 랙 구성은 OEM과 생산 로트에 따라 차이가 존재합니다.
컴퓨트 트레이 단위 분할 기준PER TRAY
| 항목 | 단일 컴퓨트 트레이 (×18) |
|---|---|
| GPU | 4× Blackwell Ultra(합계 1,152GB HBM3e) |
| CPU | 2× Grace(72코어 ×2, 합계 1TB LPDDR5X) |
| 랙 내 네트워크 | 4× ConnectX-8(각 800Gb/s) + 1× BlueField-3 DPU |
| 인터커넥트 인터페이스 | 후면 NVLink 케이블 카트리지(cable cartridge)로 NVSwitch 트레이에 블라인드 접속; 수랭 인터페이스는 블라인드 접속으로 랙 매니폴드에 연결 |
| 운영 관리상 의미 | 컴퓨트 트레이는 개별 탈착 유지보수 가능——트레이 레벨 시리얼번호와 펌웨어 리포트가 검수의 최소 단위(「구매 및 검수」 참조) |
트레이 단위 기준은 NVIDIA 참조 아키텍처 문서 출처[2].
세대 비교 · 두 세대 NVL72 한눈에GENERATIONS
| 항목 | GB200 NVL72 | GB300 NVL72 |
|---|---|---|
| GPU | 72× Blackwell | 72× Blackwell Ultra |
| 보드당 메모리 | 192GB HBM3e | 288GB HBM3e |
| GPU 메모리 합계 | 13.8TB(추정 기준) | 20.7TB(추정 기준; 공식 페이지 20TB) |
| 공식 상대 성능 | 벤치마크 | 1.5× AI performance(보도자료 기준) |
| 네트워크 | ConnectX-7 400G | ConnectX-8 800G |
GB200은 공개 기준 비교로 분류, 상세는 NVIDIA 공식 자료 참조; 두 세대 모두 완전 수랭, 36× Grace 아키텍처.
패밀리 라인업FAMILY
GB300 패밀리는 폼팩터별로 4개 라인으로 나뉘며, 본 라이브러리 유통은 GB300 NVL72 풀랙과 DGX GB300이 주력이다(중국 시장의 B300 NVL8 공랭 완제 시스템은 B300 항목 참조):
냉각 및 배치COOLING & DEPLOYMENT
GB300 NVL72 수랭 한 가지 형태만 존재: 컴퓨트 트레이와 NVSwitch 트레이 전부 콜드플레이트 액냉이며, 수랭 인터페이스는 트레이 후면의 블라인드 커넥터로 랙 매니폴드에 접속, 랙 내 CDU 250kW급(슈퍼마이크로 기준, 전원 이중화)이 2차측 순환을 구동; NVIDIA 참조 아키텍처는 트레이 레벨 + 랙 레벨 2단 누액 감지[2][4]를 요구합니다. 이것의 배치는 '서버 한 대 구매'가 아니라 하나의 서버룸 엔지니어링 프로젝트:


모델 및 클러스터 적합성MODEL & CLUSTER FIT
| 모델 / 시나리오 | 메모리 수요 (FP8 추정) | GB300 NVL72 배치 (단일 랙 20.7TB 추정 기준) | AIXX Index |
|---|---|---|---|
| DeepSeek R1 풀 버전 (671B) 다중 레플리카 추론 | 약 690GB / 레플리카 | 단일 랙에 20+ 레플리카 동시 상주 가능(가중치 기준 추정, KV cache 미포함)——고동시 추론 팩토리의 자신감 | 96 |
| 조 단위 파라미터급 MoE 학습 | 가중치+옵티마이저 상태 TB급 | 72카드 NVLink 도메인 내 텐서/전문가 병렬화, 그래디언트가 랙을 벗어나지 않음; 다중 랙은 800G로 확장 | 95 |
| 롱 컨텍스트 (백만 토큰급) | KV cache는 컨텍스트에 비례해 선형 증가 | 20TB 풀링 메모리가 KV에 넉넉한 여유를 제공해, 랙 한 대로 대규모 동시성 장문 컨텍스트 처리 가능 | 92 |
| 7B-14B급 소형 모델 배치 생산 라인 | 약 8-30GB / 인스턴스 | 구동은 가능하지만 '닭 잡는 데 소 잡는 칼' — 이런 라인은 B300 NVL8 / H200이 더 경제적(경제성 기준) | 58 |
메모리는 FP8 웨이트 기준 ≈ 파라미터 수 × 1 바이트로 추산(추정 기준, KV cache 및 활성화 여유 미포함); AIXX Index는 본 라이브러리의 랙 수준 추정 기준이며 실측에 따라 업데이트됩니다. 클러스터 확장 형태(DGX SuperPOD / 멀티랙 InfiniBand 상호 접속)는 NVIDIA 참조 설계를 따릅니다.
갤러리GALLERY


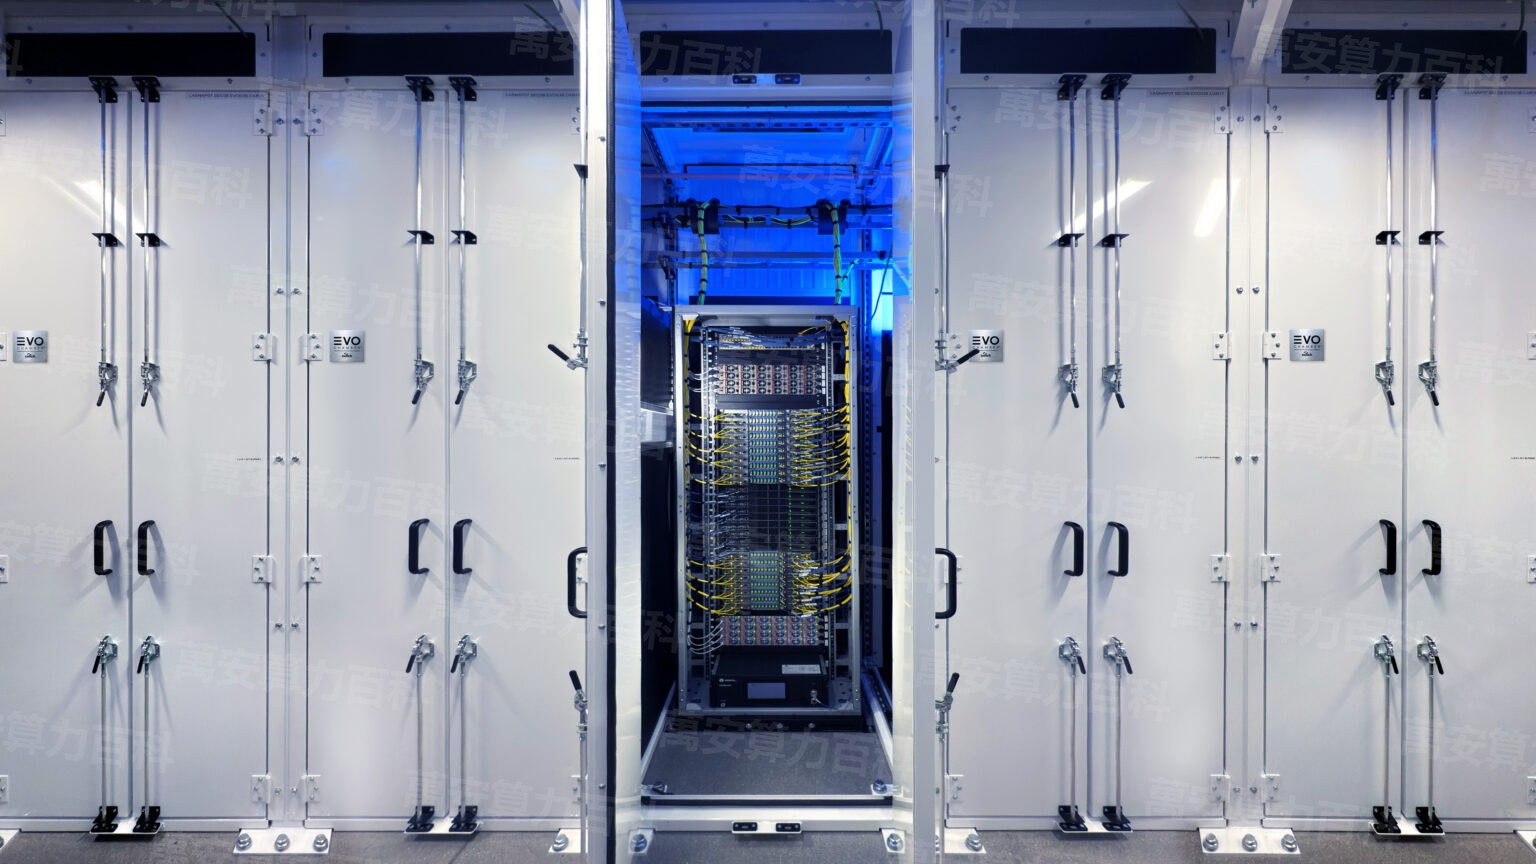
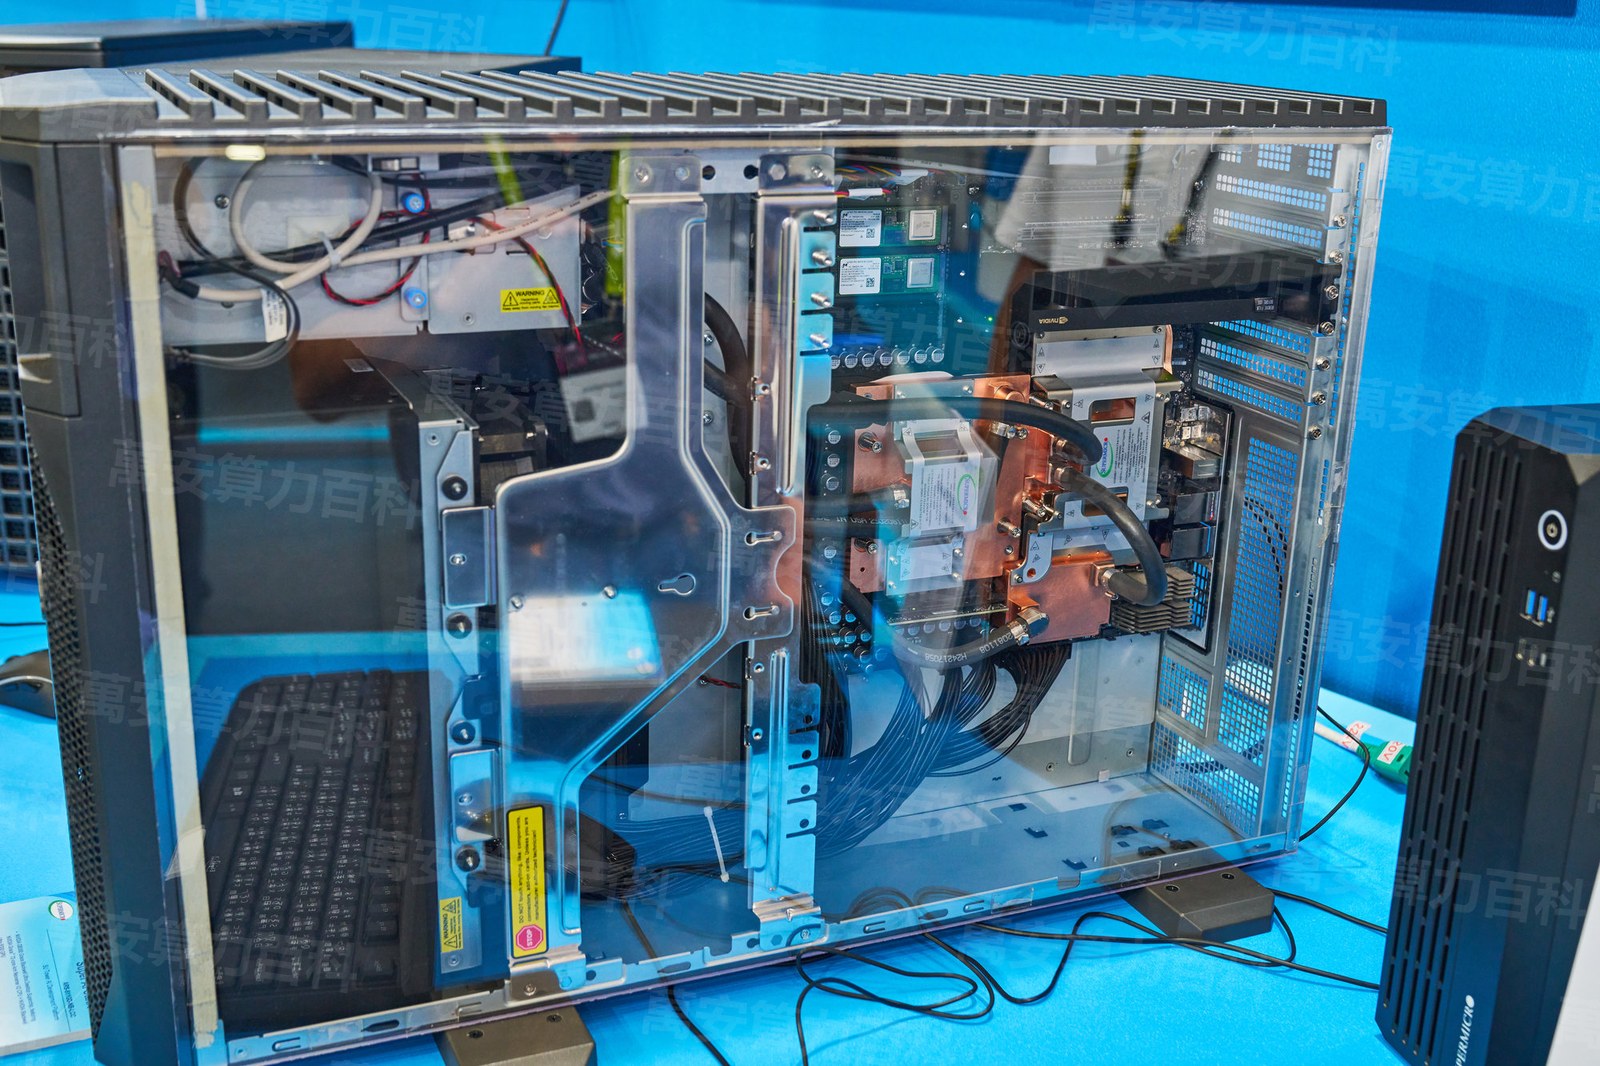
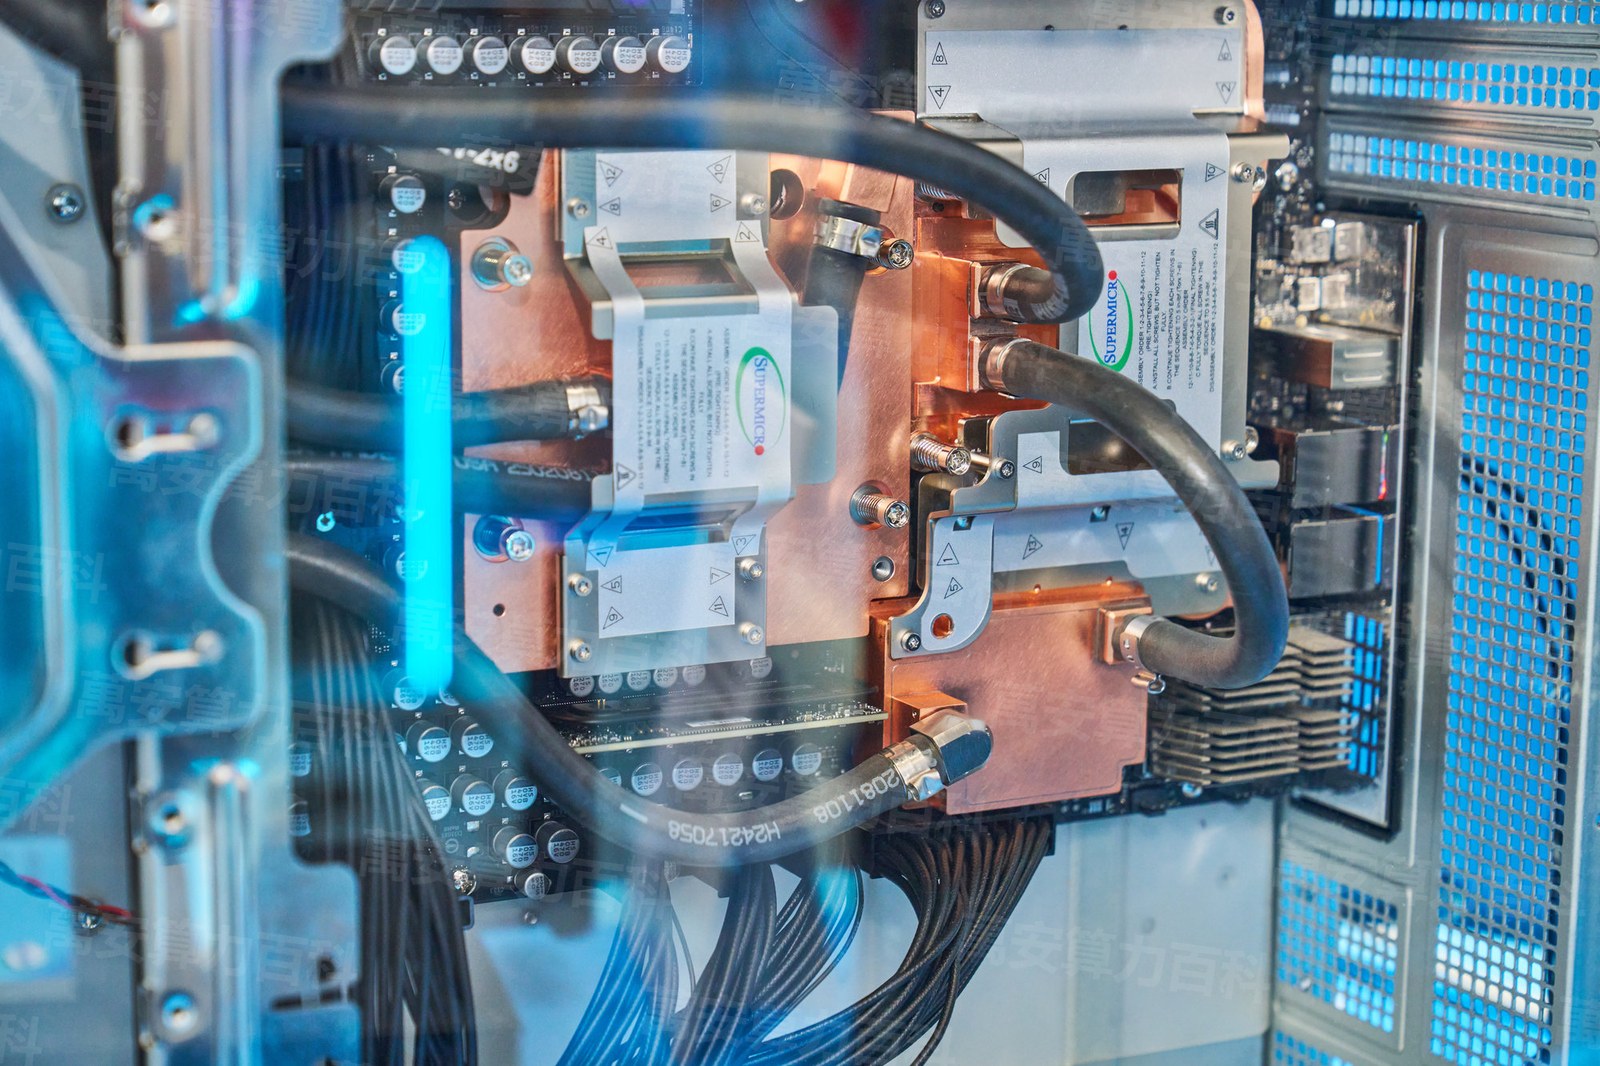
실사 이미지는 검수 배치별로 지속 추가됩니다; 공식 렌더링 이미지는 실사로, AI 생성 이미지는 실사로 표기하지 않습니다.
영상 해설VIDEO
본 영상은 GB300 NVL72 전용 랙 수준 배치 관점(랙 전체 설치 → 전원 공급 → 수랭 → 네트워크 → 상전 검수)이며, 파라미터와 판례는 모두 GB300 NVL72 실측 기준입니다. 내레이션과 장면 텍스트 아카이브는 리포지터리 _wiki_work_1006/gen_tts_gb300.py 참조.
커뮤니티 실기기 · 출처 YouTubeCOMMUNITY HANDS-ON
일부 지역에서는 바로 재생되지 않을 수 있습니다
소프트웨어와 에코시스템ECOSYSTEM
| 항목 | 요구 사항 / 현황 |
|---|---|
| CUDA / 드라이버 | B300과 동세대·동스택: Blackwell 세대 지원 라인(CUDA 12.8부터 완전 지원), 자세한 내용은 B300 항목과 NVIDIA 공식 문서 참조 |
| 집합 통신 | NCCL은 NVLink5 / NVSwitch 풀 상호연결에 네이티브 최적화——시스템 수준 검수는 nccl-tests 전 기기 연동 테스트를 기준으로 합니다(「검수 방법」 참조). |
| 클러스터 관리 | NVIDIA Base Command / DGX SuperPOD 참조 설계; 서드파티 Slurm / Kubernetes 생태계 범용(공개 기준) |
| 추론 엔진 | vLLM / SGLang / TensorRT-LLM 모두 Blackwell Ultra 지원(FP4 경로는 세대 신규 기능으로, 각 엔진 릴리스 기준) |
| 네트워크 구성 | Quantum-X800 InfiniBand / Spectrum-X Ethernet 800G 광 인터커넥트(멀티랙 확장) |
| 운영 모니터링 | DCGM / 트레이 수준 대역외 관리(SN2201 대역외 스위치)— RAS 이벤트 카운트는 랙 검수의 핵심 지표 |
소프트웨어 스택 버전은 시간에 따라 진화하므로 NVIDIA 공식 발표를 기준으로 합니다. 생태계 성숙도 판단은 B300 항목(동세대 공유) 참조.
구매 및 검수PROCUREMENT
GB300 NVL72 구매 시 검수 포인트(3항목, 랙 수준 기준):
랙 수준 검수 5항목 판례는 본 항목 참조'검수 방법'절 참조.
검수 방법 (랙 레벨)RACK ACCEPTANCE
랙 수준 검수 5항목 기준(단일 카드 스트레스 테스트와는 별개 체계, 수치 판례는 모두 GB300 NVL72 실측 기준): 상전 자가 진단 → 수랭 캘리브레이션 → 시스템 전체 소비 전력 → NCCL 전체 머신 연동 테스트 → RAS 이벤트 카운트.
본 절은 시스템 수준 검수 기준이며, 단일 카드 항목의 「스트레스 테스트 방법」 6개 판례와는 호환되지 않습니다. ≥85% 등 비율선은 본 데이터베이스의 검수 기준(추정)이며, 최종적으로 OEM 검수 규범을 기준으로 합니다.
운송과 납품LOGISTICS
OEM과 변형 모델VENDORS
동일한 GB300 NVL72 참조 아키텍처, 각사 풀랙의 차이는 납품, 수랭 인프라 및 서비스에 있다 — 선정 전 차이를 먼저 확인하라(본 라이브러리 유통은 Supermicro / Dell 기준 커버):
| 완제품 제조사 | 대표 폼팩터 | 차이점 | 적합한 대상 |
|---|---|---|---|
| Supermicro 슈퍼마이크로 | SRS-GB300-NVL72(본 라이브러리 유통 기준) | 머신 내 CDU 250kW급, 8× 33kW 전원 프레임 완전랙 인도, 수랭 구성 자체적으로 클로즈드 루프[4] | 현물 구매 · 수랭 구성 원스톱 |
| Dell 델 | GB300 NVL72 풀랙(본 라이브러리 유통 기준; CoreWeave 최초 납품처) | 글로벌 톱티어 서비스 네트워크, 퍼블릭 클라우드 대량 주문 인도 경험[8] | 국제 배포 · 서비스 중시 |
| NVIDIA 공식 | DGX GB300 / DGX SuperPOD | 공식 올인원 납품 + 풀스택 소프트웨어(본 라이브러리 유통 31건 USD 기준) | 개봉 즉시 훈련 · 원 제조사 지원 |
| Lenovo / HPE / Cisco | GB300 NVL72 완전랙 | 엔터프라이즈급 서비스 네트워크(보도자료 파트너 명단 기준[3]) | 엔터프라이즈 고객 채널 구매 |
| Wiwynn / Pegatron / Quanta 등 | ODM 완전랙 / OEM 생산 | 클라우드 사업자 공급망 후단(CoreWeave 등의 인도 형태 중 하나) | 클라우드 사업자 대량 주문 · ODM 채널 |
AIXX Index · 배치 4개 지표 비교(랙 수준)AIXX INDEX
| 완제품 제조사 | 설치 용이성 | 유지보수 편의성 | 성능 밀도 | 수명 전망 |
|---|---|---|---|---|
| Supermicro 슈퍼마이크로 | 72 | 80 | 95 | 82 |
| Dell 델 | 78 | 88 | 95 | 85 |
| NVIDIA 공식 | 82 | 85 | 94 | 85 |
| Lenovo / HPE / Cisco | 76 | 86 | 94 | 84 |
| ODM(Wiwynn/Pegatron/Quanta) | 68 | 72 | 95 | 80 |
AIXX 지수는 본 데이터베이스의 시스템 수준 추정 기준(0–100, 점수 산정 근거=풀 랙 납품 형태, 액침 인프라 및 서비스 네트워크 차이; 「설치 용이성」은 공랭 8카드 시스템보다 전반적으로 낮으며, 이는 시스템 수준 배포의 객관적 속성이지 제조사의 단점이 아님), 실기 검증에 따라 업데이트되며 구매 약속을 구성하지 않습니다. 구체적 모델은 제조사 공식 발표 기준.
용어 카드GLOSSARY
NVL72 / 슈퍼노드
N=NVLink 도메인, 72=도메인 내 GPU 수. 72개 GPU가 NVSwitch로 풀 인터커넥트되어 하나의 NVLink 도메인을 형성하고, 소프트웨어에는 하나의 '거대 가속기'로 표시 — 이것이 '슈퍼노드'의 의미이자 랙 수준 제품과 8카드 시스템의 본질적 차이.
Compute Tray 컴퓨트 트레이
랙의 최소 컴퓨팅 단위: 트레이당 4× Blackwell Ultra(합계 1,152GB HBM3e)+ 2× Grace(합계 1TB LPDDR5X), 총 18개 트레이. 트레이는 개별 탈착 가능 — 트레이 수준 시리얼넘버와 펌웨어 리포트가 랙 검수의 최소 신뢰 단위.
NVSwitch Tray 스위치 트레이
9개 스위치 트레이가 72카드의 풀 인터커넥트를 담당: 컴퓨트 트레이는 후면 NVLink 케이블 캐트리지(cable cartridge)로 스위치 트레이에 블라인드매트 접속, 논블로킹 P2P 매트릭스를 구성 — 합계 130TB/s의 NVLink5 대역폭이 여기서 나옵니다.
CDU와 블라인드매트 수랭
CDU(Coolant Distribution Unit, 냉매 분배 장치)는 머신 내 250kW급으로 2차 측 수랭 루프를 구동; 컴퓨트 트레이와 랙 manifold 사이는 블라인드매트(blind-mate) 커넥터 — 트레이를 밀어 넣으면 수로가 연결됩니다. 트레이 수준 + 랙 수준 2단 누액 감지는 표준 사양.
Grace CPU
NVIDIA의 Arm 아키텍처 CPU(Neoverse V2, 72코어), 랙당 36개, 트레이당 2개, LPDDR5X 메모리(합계 17TB)장착. Grace는 GPU를 '먹이는' 역할: 데이터 전처리, 통신과 스케줄링을 담당하며, GPU↔CPU는 NVLink-C2C로 상호 접속.
수출 규제와 컴플라이언스 배치
GB300은 미국의 대중국 수출 통제 대상이며 대중국 승인 목록에 포함되지 않음(2026-10 공개 기준); 현물 유통은 해외 및 자유무역구 채널이 중심. 배치와 통관 경로는 보증과 가치 유지에 영향을 미치며, 검수 시 필수 확인. 본 라이브러리 표현은 모두 공개 보도 기준이며 법적 의견을 구성하지 않습니다.
동향과 관련 이슈TIMELINE
한계와 논쟁점LIMITS
- 배치 장벽은 또 다른 면모: 풀 수랭 + 132kW급 전력 공급(참조 아키텍처 풀 로드 최대 142kW)+ 톤급 랙 하중 — 기존 공랭 데이터센터는 사실상 불가, 기관 개조 기간은 흔히 월 단위; 기관 개조 예산이 부족하다면 B300 NVL8 공랭 시스템이 더 현실적인 첫걸음('냉각과 배치' 참조)。
- 세대 간 압박이 공개화: 2026년 9월 같은 MLPerf 라운드에서, 차세대 Vera Rubin NVL72가 데뷔와 동시에 GB300 대비 최대 3.7배로 압도(Qwen3-VL, NVIDIA 공식 블로그 기준[6]) — 플래그십 랙의 우위 기간은 분기 단위로 계산되며, 조달 결정은 감가상각 리듬을 잘 계산해야 한다.
- 대중국 수출 통제 대상(중립적 표현): GB300은 대중국 승인 목록에 없으며(2026-10 공개 기준), 현물 유통은 해외 및 자유무역지대 채널이 중심이고, 통관 경로와 컴플라이언스 상태가 보증과 잔존가치에 직접 영향을 미친다[10]. 본 라이브러리는 공개 보도 기준만을 기록하며, 법적 의견을 구성하지 않는다.
- 가격 규모와 유동성: 랙당 수백만 달러급(전 세대 GB200 NVL72 공개 보도 약 $300만/랙[9]), 배치 단위 요청가 기준이 주류 — 단일 랙 단위 유통 시장은 매우 미성숙하며, 잔존가치는 서버실 조건과 원사 보증 승계에 크게 좌우되고, 단일 카드보다 매도 비용이 훨씬 높다.
- 메모리 용량 기준 차이(18TB vs 20TB): 공식 페이지 기준 20TB(288GB×72=20.7TB, 계산 일치), 초기 채널 자료에는 18TB 표기 존재 — 견적 및 계약은 공식 20TB 기준으로 대조하고, 검수는 트레이 단위 펌웨어 리포트 실측 기준(본 라이브러리 유통 config 문자열에는 여전히 18TB 표기가 있으며, 본 항목 기준 주석에 명시됨).
- '하나의 대형 카드'의 또 다른 면: NVLink 도메인은 성능의 원천이자 리스크의 경계 — 도메인 내 장애 영향 범위는 랙 전체 수준이며, 운영에는 트레이 수준 격리와 신속한 트레이 교체 능력이 필요('검수 방법' RAS 항목 참조). 이는 운영팀에 실질적인 역량 요구.
시세 밴드MARKET DATA
| 날짜 | 기준 | 지역 | 참고 가격대 | 비고 |
|---|---|---|---|---|
| 2026-10-30 | 마켓 실시간 | 미국(USD) | $723만 – 918만 | 48건 견적 ›(랙 전체 요가 기준) |
| 2026-10 | 채널 참고 | 중국 본토 | ¥11,000만 – ¥13,000만 | 대륙 현물 채널 확인 기준(랙 전체 요가 기준)· 유통 풀랙 › |
| 2026-10-30 | 마켓 실시간 | 중동(AED) | AED 4,816만 – 6,264만 | 70건의 호가(풀랙 요가 기준) |
| 2026-10-30 | 마켓 실시간 | 유럽(EUR) | €998만 – 1,267만 | 60개 제시가 (랙 전체 호가 기준) |
| 2026-10-30 | 마켓 실시간 | 싱가포르(SGD) | S$2,069만 – 2,601만 | 55건 견적(풀랙 요청가 기준) |
| 2026-10-30 | 마켓 실시간 | 일본(JPY) | JPY 226,101만 – 286,880만 | 49건 견적(풀랙 요청가 기준) |
| 2025-12 | 채널 참고 | 글로벌 | 이전 세대 GB200 NVL72 약 $300만 / 랙 | 공개 보도 기준[9]· GB300 공식 표준가 없음 · 유통 풀랙 › |
| 2026-10-30 | 정책 기준 | 중국 본토 | 대중국 승인 목록 미포함 | GB300은 미국 수출 통제 대상으로, 현물 유통은 해외 및 자유무역구 채널이 중심(공개 보도 기준, 법적 의견을 구성하지 않음) |
기준:대륙 현물 채널 추정 밴드— 2025-08 출시 참고 가격부터는 추정 밴드(해외 채널 참고 기준 $3.4M/랙급 환산 ≈¥2,450–2,700만, NVIDIA 공식 정가 없음; 밴드=채널/구성 변동), 2026-10부터는 대륙 현물 채널 확인 기준(¥1.1억-1.3억/랙); 해외 채널 참고 기준($3.4M급)과 중국 내 현물은 서로 다른 병행 시장으로 상호 환산하지 않는다. 북미/유럽/싱가포르/일본/중동은 시세 스냅샷으로 일별 축적(USD 344.4-422.9만 · 25건 등, 2026-10-08부터, 모두 원화 기준, 상호 환산 없음). GB300은 대중국 승인 목록에 없으며, 중국 내 견적은 해외 및 자유무역지대 채널 맥락(공개 보도 기준, 법적 의견 아님). 본 라이브러리 가격 정리:AIXX 거래소(수수료 0% 매칭, 거래에 참여하지 않으며 체결가를 파악하거나 추측하지 않아 데이터의 중립성이 유지됨). 실제 가격은 판매자 제시가 기준.
가격 주요 이벤트MILESTONES
자주 묻는 질문FAQ
NVIDIA가 2025년 3월 GTC에서 발표한 Blackwell Ultra 슈퍼노드 랙: Blackwell Ultra GPU 72개 + Grace CPU 36개를 완전 수랭 랙 하나에 수납하고, NVLink5 풀 인터커넥트 합계 130TB/s로 소프트웨어에는 하나의 가속기로 인식된다. FP4 Tensor Core 공식 스펙 1,440 PFLOPS(dense 기준), GPU 메모리 합계 20TB HBM3e.
서버실과 규모를 보라: NVL72는 132kW급 전력, CDU 수랭 및 내하중 개조가 필요하며, 20TB 메모리를 하나의 NVLink 도메인으로 묶어 대규모 학습·추론 팩토리 형태다; NVL8은 카드당 288GB, 시스템 2.3TB로 기존 서버실에 분할 배치가 가능하다. 서버실 개조 예산이 있으면 NVL72, 없으면 NVL8부터 시작하라(본 라이브러리 유통에는 두 형태 모두 있음, 시세 밴드 참조).
GB300은 미국 수출 통제 대상으로 대중 승인 목록에 없다(2026-10 공개 기준, 2026년 7월 대중 승인 물량 확대는 H200); 현물 유통은 해외 및 자유무역구 채널이 중심이다. 본 항목은 공개 보도 기준이며 법적 의견을 구성하지 않으므로, 구매 전에는 주관 부처의 정책과 전문 컴플라이언스 의견을 따른다.
NVIDIA 공식 페이지 기준 20TB HBM3e(288GB/카드 × 72 = 20.7TB, 계산 일치; Red Hat 인증 카탈로그 동일 기준); 초기 채널 자료에는 18TB 표기 존재(본 라이브러리 일부 유통 config 문자열에 여전히 있음). 공식 20TB를 기준으로 하며, 견적과 계약은 이를 대조하고, 검수는 트레이 단위 펌웨어 리포트 실측 기준.
유효하지 않다 — 랙 단위는 별도의 검수 체계를 따른다: 전원 인가 자가 점검(18+9 트레이 각각 정상 보고), 수랭 캘리브레이션(CDU 유량/온도차/누수 감지 경보 0), 시스템 전체 소비 전력(풀 로드 132-142kW급 정렬), NCCL 전 기기 연동 테스트(72카드 all_reduce로 NVLink5 정격 확인), RAS 이벤트 카운트(미교정 ECC 및 인터럽트 없음). 트레이별 시리얼넘버 실물 대조가 랙 검수의 최소 신뢰 단위다(「검수 방법」 참조).
관련 항목SEE ALSO
모델 비교 및 선택COMPARE
참고 자료REFERENCES
- NVIDIA 공식 웹사이트 — GB300 NVL72 제품 페이지(스펙 기본 자료, 2026-10 검증) https://www.nvidia.com/en-us/data-center/gb300-nvl72/
- NVIDIA — 엔터프라이즈 레퍼런스 아키텍처 NVL72 AI Factory: 시스템 구성 요소(트레이/전원/수랭 기준, 2026-10 검증) https://docs.nvidia.com/enterprise-reference-architectures/n…
- NVIDIA 뉴스룸 — NVIDIA Blackwell Ultra AI Factory Platform Paves Way for Age of AI Reasoning(2025-03-18 발표: 1.5×/H2 2025/16개 파트너/CX-8 800G) https://nvidianews.nvidia.com/news/nvidia-blackwell-ultra-ai…
- Supermicro — SRS-GB300-NVL72 공식 페이지(132kW / CDU 250kW / 크기) https://www.supermicro.com/en/products/rack/srs-gb300-nvl72
- Red Hat 인증 카탈로그 — GB300 NVL72(1.1 ExaFLOPS / 20.7TB HBM3e 파트너 카탈로그 기준) https://catalog.redhat.com/en/hardware/system/detail/307917
- NVIDIA 공식 블로그 — Vera Rubin NVL72 MLPerf 첫 등장, Qwen3-VL GB300 대비 최대 3.7×(2026-09-16) https://blogs.nvidia.com
- MLCommons — MLPerf Inference v6.1 결과(GB300 NVL72 첫 등장, MoE 최대 2.5×, 2026-09-17) https://mlcommons.org
- CoreWeave — GB300 NVL72 클라우드 인스턴스 GA(2025-08-19 changelog) 및 2025년 3분기 실적 발표「First to deploy」 https://docs.coreweave.com
- Forbes — GB200 NVL72 랙당 약 $300만(2025-12-23, 전 세대 가격 앵커) https://www.forbes.com
- CNBC / 미국 — 대중 수출 통제 및 2026-01 BIS 신규 규정(공개 보도 기준) https://www.cnbc.com
- Pegatron NVIDIA GB300 NVL72 and More at NVIDIA GTC 2025(컴퓨트 트레이 실물 사진) https://www.servethehome.com/pegatron-nvidia-gb300-nvl72-and…
- Supermicro NVIDIA B300 및 AI Factory 둘러보기(Supermicro GB300 NVL72 랙 실물 사진) https://www.servethehome.com/checking-out-the-supermicro-nvi…
- 시세 밴드 데이터 — AIXX 거래소(본 플랫폼 유통 견적 및 채널 확인 구간, 매일 업데이트) /hall.html